


In de technologie-industrie kun je nauwelijks een gesprek voeren zonder dat iemand het heeft over inferentie, kunstmatige intelligentie (AI) en machine learning (ML). Het is echter belangrijk op te merken dat hoewel al deze termen met elkaar verbonden zijn, ze ook aanzienlijk verschillen.
In dit artikel leggen we de fundamentele verschillen uit en benadrukken we het belang van het gebruik van op tensorverwerking-gebaseerde edge-AI-technologie, vooral in edge- en embedded-systemen. Vergeleken met oplossingen op basis van grafische verwerkingseenheden (GPU's) bieden tensorverwerkingseenheden (TPU's) efficiëntere en kosteneffectievere prestaties. We geven ook enkele gebruiksvoorbeelden die illustreren waar u in de toekomst edge AI-oplossingen kunt tegenkomen.
Grondbeginselen van ML en inferentie
ML verwijst naar de methodologie van trainingsmodellen die representatieve gegevens gebruiken om machines in staat te stellen taken uit te voeren. Dit proces kan zeer rekenintensief zijn en biljoenen bewerkingen per nieuw trainingsdatapunt genereren. Het iteratieve karakter van het trainingsproces, gecombineerd met de enorme trainingsdatasets die nodig zijn om een hoge nauwkeurigheid te bereiken, stimuleert de vraag naar verwerking met uiterst hoge -drijvende- drijvende komma's. ML-training kan het beste worden geïmplementeerd als datacenterinfrastructuur, waar hoge kapitaal- en operationele kosten kunnen worden gerechtvaardigd door deze over meerdere klanten af te schrijven.
Inferentie omvat het gebruik van getrainde modellen om potentiële overeenkomsten te genereren voor nieuwe gegevens die relevant zijn voor de representatieve gegevens waarop het model is getraind. Inference streeft ernaar om binnen milliseconden snelle antwoorden te geven. Voorbeelden van gevolgtrekkingen zijn onder meer spraakherkenning, real-taalvertaling, machine vision en optimalisatiebeslissingen voor advertentie-invoeging. Hoewel voor inferentie slechts een fractie nodig is van de verwerkingskracht die nodig is voor training, overtreft deze nog steeds ruimschoots wat traditionele op centrale verwerkingseenheden (CPU)-gebaseerde systemen kunnen leveren, vooral voor computer vision-toepassingen. Dit is de reden waarom zoveel bedrijven zich wenden tot op tensor-gebaseerde versnellingsoplossingen-of het nu als IP op SoC's is of als in-systeemversnellers-om de reactietijden van minder-seconden te bereiken die aan de rand nodig zijn. De realiteit is dat zelfs maar een minuut of een paar seconden besteden aan het verwerken van beelden in een vision-systeem niet erg nuttig is. Industriële vision-systemen streven naar verwerkingssnelheden op milliseconden-niveau.
Het scheiden van training en gevolgtrekking
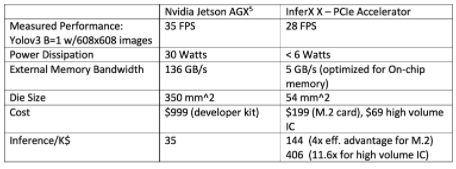
Als u dezelfde hardware implementeert die wordt gebruikt voor training in het verwerken van deductiewerkbelastingen, kan dit resulteren in het over-inrichten van inferentiemachines met versnellers en CPU-hardware. GPU-oplossingen die de afgelopen tien jaar voor ML zijn ontwikkeld, zijn niet noodzakelijkerwijs de optimale keuze voor grootschalige implementatie-van ML-inferentietechnologieën. Het onderstaande diagram illustreert perfect de vergelijking tussen TPU-versnellers en GPU-versnellers. Hieruit blijkt duidelijk dat TPU-versnellers een lager energieverbruik, lagere kosten en een hogere efficiëntie bieden in vergelijking met op GPU-gebaseerde AGX-oplossingen, terwijl ze nog steeds overtuigende prestatieniveaus bieden voor inferentietoepassingen.
Een andere kritische overweging bij het benaderen van ML-trainings- en inferentieoplossingen is de softwareomgeving. Tegenwoordig zijn er talloze populaire bibliotheken in gebruik, zoals CUDA voor NVIDIA GPU's, ML-frameworks zoals TensorFlow en PyTorch, geoptimaliseerde cross-platform-modelbibliotheken zoals Keras, en meer. Deze toolkits zijn essentieel voor het ontwikkelen en trainen van ML-modellen, maar inferentietoepassingen vereisen een andere, kleinere set softwaretools.
Inferentietoolkits zijn gericht op het uitvoeren van modellen op doelplatforms. Ze ondersteunen het overzetten van getrainde modellen naar platforms, wat mogelijk enkele operatortransformaties, kwantisering en hostintegratiediensten met zich meebrengt. Dit vertegenwoordigt echter een relatief eenvoudige reeks functionaliteiten vergeleken met de functionaliteiten die nodig zijn voor modelontwikkeling en training.
Inferentietools hebben er baat bij om te beginnen met een gestandaardiseerde weergave van het model. De Open Neural Network Exchange (ONNX) is het standaardformaat voor het weergeven van ML-modellen. Zoals de naam al aangeeft, is het een open standaard die wordt beheerd als een Linux Foundation-project. Technologieën als ONNX maken de ontkoppeling van trainings- en inferentiesystemen mogelijk, waardoor ontwikkelaars de vrijheid krijgen om voor elk verschillende geoptimaliseerde platforms te kiezen.
Voorbeeld visuele toepassingen
Naarmate ML- en inferentieprocessortechnologieën zich blijven ontwikkelen en evolueren, nemen de toepassingen toe. Hieronder staan slechts enkele plaatsen waar u deze technologie in de toekomst kunt tegenkomen.
Edge-servers in ondernemingen zoals fabrieken, ziekenhuizen, winkels en financiële instellingen. In industriële omgevingen kan AI bijvoorbeeld helpen met voorraadbeheer, defectdetectie en zelfs voorspellend onderhoud voordat er zich problemen voordoen. In de detailhandel maakt het functies mogelijk zoals pose-inschatting, waarbij computervisie wordt gebruikt om de menselijke houding te detecteren en analyseren. Gegevens uit deze analyse helpen fysieke -en- retailers het menselijk gedrag en het bezoekersverkeer in hun winkels beter te begrijpen, waardoor ze de winkelindeling kunnen optimaliseren voor maximale omzet en klanttevredenheid.
Beeldvorming met hoge-precisie/hoge-kwaliteit voor toepassingen zoals robotica, industriële automatisering/inspectie, medische beeldvorming, wetenschappelijke beeldvorming, bewakings- en objectherkenningscamera's en fotonica. Machine learning-methoden hebben bijvoorbeeld het vermogen aangetoond om kanker te detecteren door digitale röntgen-stralen te verwerken. Dit proces omvat de ontwikkeling van een ML-model dat is ontworpen om röntgenbeelden te verwerken, waarbij doorgaans getrainde semantische segmentatie-algoritmen worden gebruikt om kankerlaesies te identificeren. Tijdens de training worden door radiologen geïdentificeerde kankerbeelden gebruikt om het netwerk te leren wat geen kanker is, wat wel kanker is en hoe verschillende soorten kanker voorkomen. Hoe meer een ML-model wordt getraind, hoe beter het wordt in het maximaliseren van correcte diagnoses en het minimaliseren van verkeerde diagnoses. Dit betekent dat machinaal leren niet alleen afhankelijk is van intelligent modelontwerp, maar ook van enorme hoeveelheden (tienduizenden tot miljoenen) zorgvuldig samengestelde gegevensvoorbeelden waarin kanker vakkundig is geïdentificeerd.
Slimme winkelwagentjes-Verschillende bedrijven ontwikkelen en implementeren intelligente winkelsystemen die producten niet herkennen aan hun UPC-barcodes, maar aan de visuele verschijning van de verpakking zelf. Met deze functie kunnen klanten eenvoudig artikelen in de winkelwagen of op het kassasysteem plaatsen zonder de UPC-code te hoeven lokaliseren en deze te scannen met een UPC-laserscanner. Deze technologie maakt het winkelproces nauwkeuriger, sneller en handiger.
De juiste beslissing nemen
Bedrijven moeten vandaag alle beschikbare oplossingen evalueren en de optimale kiezen op basis van hun specifieke gebruikscasus. Ze kunnen er ook niet simpelweg van uitgaan dat alle AI-oplossingen het beste kunnen worden geïmplementeerd op GPU-apparaten, omdat op TPU-gebaseerde oplossingen een hogere verwerkingsefficiëntie en een lager siliciumgebruik bieden, waardoor het stroomverbruik en de kosten worden verlaagd.